视觉模型 / 拍不烂 · 自研视觉模型
用一句描述, 找到人,关联轨迹。
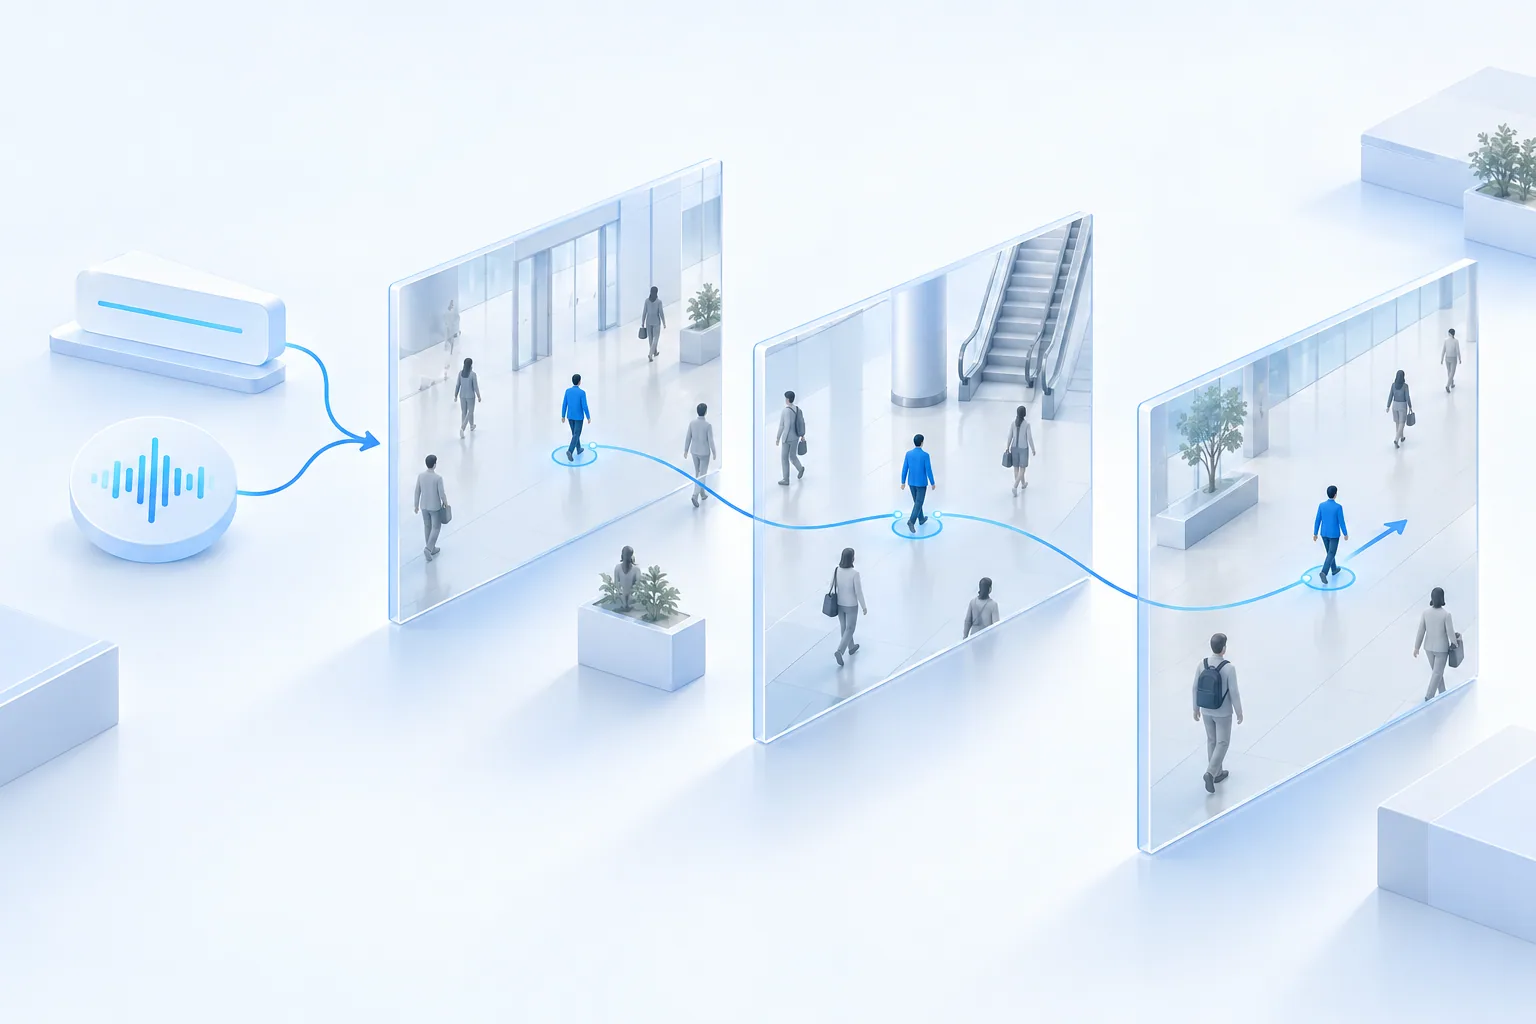
基于自研视觉模型「拍不烂」,支持以文搜图、以文搜人,以及语音转文字后的检索入口,面向大规模人员搜索、跨场景查找与人员追踪。
输入与数据
MODEL CAPABILITIES
以衣着、行为或场景描述作为检索条件,查找相关图像与人员候选。
把口述条件转为文字,再进入同一条视觉检索流程。
结合时间、区域与场景缩小搜索范围,定位相关人员与记录。
关联人员在不同片段或场景中的出现记录,辅助查看活动轨迹。
MODEL OUTCOMES
切换不同能力,查看输入与输出。
输入
模型输出
示意展示模型的输入与输出,具体效果结合现场数据验证。
APPLICATIONS
在现场图像与视频记录中按描述查找人员。
关联时间、区域与出现记录,查看人员活动与轨迹。
按人员特征和场景条件定位相关片段,支持业务复核。
相关项目实践
矿山案例展示了人次检测、多目标跟踪、轨迹分析与电子围栏,以及禁区闯入、徘徊和尾随等事件识别,构成人员搜索与跟踪的应用背景。
PERFORMANCE & VALIDATION
同时关注模型表现与现场使用价值。
按文字与语音描述检查候选命中、排序及无匹配情况。
检查不同视角与场景下的关联、漏匹配和错误匹配。
结合记录规模、检索范围与硬件,评估搜索响应和处理能力。
按授权的图像、视频、时间和区域开展检索。语音入口先转为文字,匹配结果保留场景依据以供人工复核。
量化效果依据数据集、模型版本与现场验证条件给出。
MORE MODELS
工业诊断
时序预测